PROPOSITO DE LA CAPA DE TRANSPORTE
Cualquier host puede tener múltiples aplicaciones que se están comunicando a través de la red. Cada una de estas aplicaciones se comunicará con una o más aplicaciones en hosts remotos. Es responsabilidad de la capa de Transporte mantener los diversos streams de comunicación entre estas aplicaciones.
Segmentación de datos
Debido a que cada aplicación genera un stream de datos para enviar a una aplicación remota, estos datos deben prepararse para ser enviados por los medios en partes manejables. Los protocolos de la capa de Transporte describen los servicios que segmentan estos datos de la capa de Aplicación. Esto incluye la encapsulación necesaria en cada sección de datos. Cada sección de datos de aplicación requiere que se agreguen encabezados en la capa de Transporte para indicar la comunicación a la cual está asociada.
Reensamble de segmentos
En el host de recepción, cada sección de datos puede ser direccionada a la aplicación adecuada. Además, estas secciones de datos individuales también deben reconstruirse para generar un stream completo de datos que sea útil para la capa de Aplicación. Los protocolos de la capa de Transporte describen cómo se utiliza la información de encabezado de dicha capa para reensamblar las secciones de datos en streams y enviarlas a la capa de Aplicación.
Identificación de las aplicaciones
Para poder transferir los streams de datos a las aplicaciones adecuadas, la capa de Transporte debe identificar la aplicación de destino. Para lograr esto, la capa de Transporte asigna un identificador a la aplicación. Los protocolos TCP/IP denominan a este identificador número de puerto. A todos los procesos de software
separación de comunicaciones múltiples
Considere una computadora conectada a una red que recibe y envía e-mails y mensajes instantáneos, explora sitios Web y realiza una llamada telefónica de VoIP de manera simultánea. Cada una de estas aplicaciones envía y recibe datos en la red al mismo tiempo. Sin embargo, los datos de la llamada telefónica no se direccionan al explorador Web y el texto de un mensaje instantáneo no aparece en el e-mail.

Administración de datos
Cuando los datos llegan a la capa de transporte, los protocolos de la capa inician el proceso de encapsulado de datos. La capa de transporte encapsula los datos de aplicación en unidades de datos de protocolo de transporte.
El protocolo de capa de transporte crea un flujo virtual de datos entre la aplicación de envío y la de recepción, que se identifica con un número de puerto de transporte. El número de puerto identifica un puerto, una ubicación dedicada de la memoria par recibir o enviar datos. Además, la capa de protocolo de transporte puede proporcionar otros servicios, como la entrega de datos ordenada y fiable. El resultado final depende de si la información se maneja con los protocolos TCP, SCTP o UDP.
Segmentación TCP
TCP se denomina a menudo protocolo "orientado a la conexión" porque TCP garantiza la entrega correcta de los datos al host de recepción. La Figura 1–1 muestra cómo el protocolo TCP recibe el flujo del comando rlogin. A continuación, TCP divide los datos que se reciben de la capa de aplicación en segmentos y adjunta un encabezado a cada segmento.
Figura 1–1 Transferencia de un paquete a través de la pila TCP/IP
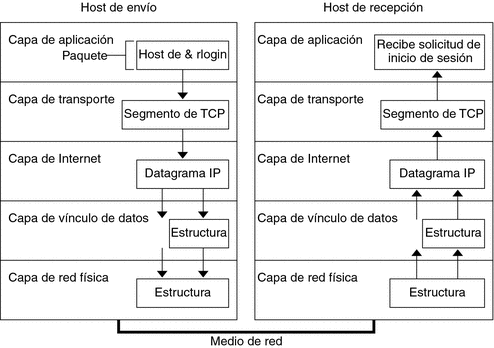
Los encabezados de segmento contienen puertos de envío y recepción, información de orden de los segmentos y un campo de datos conocido como suma de comprobación. Los protocolos TCP de ambos hosts utilizan los datos de suma de comprobación para determinar si los datos se transfieren sin errores.
Establecimiento de una conexión TCP
TCP utiliza segmentos para determinar si el sistema de recepción está listo para recibir los datos. Cuando el protocolo TCP de envío desea establecer conexiones, envía un segmento denominado SYN al protocolo TCP del host de recepción. El protocolo TCP de recepción devuelve un segmento denominado ACK para confirmar que el segmento se ha recibido correctamente. El protocolo TCP de envío emite otro segmento ACK y luego procede al envío de los datos. Este intercambio de información de control se denomina protocolo de tres vías.
Paquetes UDP
UDP es un protocolo "sin conexiones". A diferencia de TCP, UDP no comprueba los datos que llegan al host de recepción. En lugar de ello, UDP da formato al mensaje que se recibe desde la capa de la aplicación en los paquetes UDP. UDP adjunta un encabezado a cada paquete. El encabezado contiene los puertos de envío y recepción, un campo con la longitud del paquete y una suma de comprobación.
El proceso UDP de envío intenta enviar el paquete a su proceso UDP equivalente en el host de recepción. La capa de aplicación determina si el proceso UDP de recepción confirma la recepción del paquete. UDP no requiere ninguna notificación de la recepción. UDP no utiliza el protocolo de tres vías.
Establecimiento de una conexión
El establecimiento de una conexión parece fácil, pero en realidad es sorprendentemente difícil. A primera vista, parecería que es suficiente con mandar una TPDU (Unidad de Datos del Protocolo de Transporte) con la petición de conexión y esperar a que el otro acepte la conexión. El problema viene cuando la red puede perder, almacenar, o duplicar paquetes. El principal problema es la existencia de duplicados retrasados. Esto puede solucionarse de varias maneras (ninguna es muy satisfactoria). Una es utilizar direcciones de transporte desechables. En este enfoque cada vez que necesitemos una dirección la creamos. Al liberarse la conexión descartamos la dirección y no se vuelve a utilizar. O también asignar una secuencia dentro de los datos transmitidos, pero estos plantean el problema de que si se pierde la conexión perdemos el orden del identificador y ya no funciona. La solución seria más fácil si los paquetes viejos se eliminaran de la subred cada cierto tiempo de vida. Para ello podemos utilizar las siguientes técnicas: Un diseño de subred Restringido. Colocar un contador de saltos en cada paquete. Marcar el tiempo de cada paquete. Pero en la práctica no vale solo con hacer esto sino que tenemos que garantizar que todas las confirmaciones de los paquetes también se eliminan.
Liberación de una conexión
La liberación de una conexión es más fácil que su establecimiento. No obstante, hay más escollos de los que uno podría imaginar. Hay dos estilos de terminación de una conexión: liberación asimétrica y liberación simétrica. La liberación asimétrica es la manera en que funciona el mecanismo telefónico: cuando una parte cuelga, se interrumpe la conexión. La liberación simétrica trata la conexión como dos conexiones unidireccionales distintas, y requiere que cada una se libere por separado. La liberación asimétrica es abrupta y puede resultar en la pérdida de datos. Por lo que es obvio que se requiere un protocolo de liberación más refinado para evitar la pérdida de datos. Una posibilidad es usar la liberación simétrica, en la que cada dirección se libera independientemente de la otra. Aquí, un hoste puede continuar recibiendo datos aun tras haber enviado una TPDU de desconexión.
La liberación simétrica es ideal cuando un proceso tiene una cantidad fija de datos por enviar y sabe con certidumbre cuándo los ha enviado. En otras situaciones, la determinación de si se ha efectuado o no todo el trabajo y se debe terminarse o no la conexión no es tan obvia. Podríamos pensar en un protocolo en el que el host 1 diga:”Ya termine, ¿Terminaste también?”. Si el host 2 responde “Ya termine también. Adiós”, la conexión puede liberarse con seguridad.
Pero no es tan fiable por el problema de que siempre tendremos que esperar la confirmación de los mensajes recibidos y si esta confirmación no llega no libera la conexión y después puede que necesite la confirmación de que llegó la confirmación y entraríamos en un bucle del que no podemos salir.
Podemos hacer que al host 1 si no le llega la confirmación después de N intentos (es que quiere la desconexión), se libere. Esto produce una conexión semiabierta en la que el host 1 está desconectado pero el host 2 no como no le llega la confirmación no se desconecta nunca. Para solucionar esto creamos una regla por la cual si al host 2 no le llega ninguna TPDU durante cierta cantidad de segundos, se libera automáticamente.
Reconocimiento y transmisión de datos
Los servicios basados en TCP y UDP mantienen un seguimiento de las
diversas aplicaciones que se comunican. Para diferenciar los segmentos y
datagramas para cada aplicación, tanto TCP como UDP cuentan con campos de
encabezado que pueden identificar de manera exclusiva estas aplicaciones. Estos
identificadores únicos son números de puertos.
Los números de puerto se asignan de distintas maneras, en virtud de si
el mensaje es una solicitud o una respuesta. Mientras que los procesos del
servidor tienen números de puerto estáticos asignados, los clientes eligen de
forma dinámica un número de puerto para cada conversación.
La combinación del número de puerto de la capa de transporte y de la
dirección IP de la capa de red asignada al host identifica de manera exclusiva
un proceso en particular que se ejecuta en un dispositivo host específico. Esta
combinación se denomina socket. Eventualmente, los términos número de puerto y
socket se utilizan en forma indistinta.
Hay diversos tipos de números de puerto:
Puertos bien conocidos (números del 0 al 1023): estos números se reservan para servicios y
aplicaciones.
Puertos registrados (números
del 1024 al 49151): estos números de puerto se asignan a procesos o
aplicaciones del usuario. Estos procesos son principalmente aplicaciones
individuales que el usuario elige instalar en lugar de aplicaciones comunes que
recibiría un puerto bien conocido.
Puertos dinámicos o privados (números 49152 a 65535): también conocidos como puertos efímeros, están
usualmente asignados de forma dinámica a las aplicaciones cliente cuando se
inicia una conexión.
Multiplexión
La multiplexión de varias conversaciones en conexiones, circuitos virtuales o enlaces físicos desempeña un papel importante en diferentes capas de la arquitectura de red. En la capa de transporte puede surgir la necesidad de multiplexión por varias razones. Por ejemplo, si en un host sólo se dispone de una dirección de red, todas las conexiones de transporte de esa máquina tendrán que utilizarla. Cuando llega una TPDU, se necesita algún mecanismo para saber a cuál proceso asignarla. Esta situación se conoce como multiplexión hacia arriba.
La multiplexión también puede ser útil en la capa transporte para la utilización de circuitos virtuales, que dan más ancho de banda cuando se reasigna a cada circuito una tasa máxima de datos. La solución es abrir múltiples conexiones de red y distribuir el tráfico entre ellas. Esto se denomina multiplexión hacia abajo..

No hay comentarios:
Publicar un comentario