martes, 27 de junio de 2017

3.3

Protocolos de aplicación


Capa de aplicación


El nivel de aplicación o capa de aplicación es el séptimo nivel del modelo OSI y el cuarto de la pila TCP.

Ofrece a las aplicaciones (de usuario o no) la posibilidad de acceder a los servicios de las demás capas y define los protocolos que utilizan las aplicaciones para intercambiar datos, como correo electrónico (POP y SMTP), gestores de bases de datos y protocolos de transferencia de archivos (FTP).

Cabe aclarar que el usuario normalmente no interactúa directamente con el nivel de aplicación. Suele interactuar con programas que a su vez interactúan con el nivel de aplicación pero ocultando la complejidad subyacente. Así por ejemplo un usuario no manda una petición «GET /index.html HTTP/1.0» para conseguir una página en html, ni lee directamente el código html/xml. O cuando chateamos con el Mensajero Instantáneo, no es necesario que codifiquemos la información y los datos del destinatario para entregarla a la capa de Presentación (capa 6) para que realice el envío del paquete.

En esta capa aparecen diferentes protocolos y servicios: Protocolos:
FTP (File Transfer Protocol - Protocolo de transferencia de archivos) para transferencia de archivos.
DNS (Domain Name Service - Servicio de nombres de dominio).
DHCP (Dynamic Host Configuration Protocol - Protocolo de configuración dinámica de anfitrión).
HTTP (HyperText Transfer Protocol) para acceso a páginas web.
HTTPS (Hypertext Transfer Protocol Secure) Protocolo seguro de transferencia de hipertexto.
POP (Post Office Protocol) para recuperación de correo electrónico.
SMTP (Simple Mail Transport Protocol) para envío de correo electrónico.
SSH (Secure SHell)
TELNET para acceder a equipos remotos.
TFTP (Trivial File Transfer Protocol).
LDAP (Lightweight Directory Access Protocol).
XMPP, (Extensible Messaging and Presence Protocol) - Protocolo estándar para mensajería instantánea.

Capa de presentación


Esta capa es la primera en trabajar más el contenido de la comunicación que cómo se establece la misma. En ella se tratan aspectos tales como la semántica y la sintaxis de los datos transmitidos, ya que distintas computadoras pueden tener diferentes formas de manejarlas.

Por lo tanto, podemos resumir definiendo a esta capa como la encargada de manejar las estructuras de datos abstractas y realizar las conversiones de representación de datos necesarias para la correcta interpretación de los mismos.

Esta capa también permite cifrar los datos y comprimirlos. Actúa como traductor.

La Capa 6, o capa de presentación, cumple tres funciones principales. Estas funciones son las siguientes:
-Formateo de datos
-Cifrado de datos
-Compresión de datos
Resultado de imagen para la capa de la presentacion


Capa de sesión


El nivel de sesión o capa de sesión es el quinto nivel del modelo OSI , que proporciona los mecanismos para controlar el diálogo entre las aplicaciones de los sistemas finales. En muchos casos, los servicios de la capa de sesión son parcialmente, o incluso, totalmente prescindibles. No obstante en algunas aplicaciones su utilización es ineludible.

La capa de sesión proporciona los siguientes servicios:
Control del Diálogo: Éste puede ser simultáneo en los dos sentidos (full-duplex) o alternado en ambos sentidos (half-duplex).
Agrupamiento: El flujo de datos se puede marcar para definir grupos de datos.
Recuperación: La capa de sesión puede proporcionar un procedimiento de puntos de comprobación, de forma que si ocurre algún tipo de fallo entre puntos de comprobación, la entidad de sesión puede retransmitir todos los datos desde el último punto de comprobación y no desde el principio.

Todas estas capacidades se podrían incorporar en las aplicaciones de la capa 7. Sin embargo ya que todas estas herramientas para el control del diálogo son ampliamente aplicables, parece lógico organizarlas en una capa separada, denominada capa de sesión.1

La capa de sesión surge como una forma de organizar y sincronizar el diálogo y controlar el intercambio de datos.

Protocolos de la capa de sesión


  • Protocolo RPC (llamada a procedimiento remoto): es un protocolo que permite a un programa de ordenador ejecutar código en otra máquina remota sin tener que preocuparse por las comunicaciones entre ambos. El protocolo es un gran avance sobre los sockets usados hasta el momento. Las RPC son muy utilizadas dentro del paradigma cliente-servidor. Siendo el cliente el que inicia el proceso solicitando al servidor que ejecute cierto procedimiento o función y enviando éste de vuelta el resultado de dicha operación al cliente. Hoy en día se está utilizando el XML como lenguaje para definir el IDL y el HTTP como protocolo de red, dando lugar a lo que se conoce como servicios web.
  • SCP (protocolo de comunicación simple): El protocolo SCP es básicamente idéntico al protocolo RCP diferencia de este, los datos son cifrados durante su transferencia, para evitar que potenciales packet sniffers extraigan información útil de los paquetes de datos. Sin embargo, el protocolo mismo no provee autenticación y seguridad; sino que espera que el protocolo subyacente, SSH, lo asegure.
  • ASP (Protocolo de sesión APPLE TALK): Fue desarrollado por Apple Computers, ofrece establecimiento de la sesión, mantenimiento y desmontaje, así como la secuencia petición. ASP es un protocolo intermedio que se basa en la parte superior de AppleTalk Protocolo de transacciones (ATP), que es el original fiable de nivel de sesión protocolo de AppleTalk. Proporciona servicios básicos para solicitar respuestas a las arbitrarias órdenes y llevar a cabo fuera de la banda de consultas de estado. También permite al servidor enviar mensajes asíncronos de atención al cliente.
Resultado de imagen para capa de sesion

Protocolos de la capa de aplicación TCP/IP

Si bien el modelo OSI separa las funciones individuales de las capas de aplicación, presentación y sesión, las aplicaciones de TCP/IP más conocidas e implementadas incorporan la funcionalidad de las tres capas.
Los protocolos de aplicación de TCP/IP especifican el formato y la información de control necesarios para muchas funciones de comunicación comunes de Internet. Algunos de los protocolos TCP/IP son:
  • Sistema de nombres de dominios (DNS): este protocolo resuelve nombres de Internet en direcciones IP.
  • Telnet: se utiliza para proporcionar acceso remoto a servidores y dispositivos de red.
  • Protocolo simple de transferencia de correo (SMTP): este protocolo transfiere mensajes y archivos adjuntos de correo electrónico.
  • Protocolo de configuración dinámica de host (DHCP): se utiliza para asignar una dirección IP y direcciones de máscara de subred, de gateway predeterminado y de servidor DNS a un host.
  • Protocolo de transferencia de hipertexto (HTTP): este protocolo transfiere archivos que conforman las páginas Web de la World Wide Web.
  • Protocolo de transferencia de archivos (FTP): se utiliza para la transferencia de archivos interactiva entre sistemas.
  • Protocolo trivial de transferencia de archivos (TFTP): se utiliza para la transferencia de archivos activa sin conexión.
  • Protocolo bootstrap (BOOTP): este protocolo es un precursor del protocolo DHCP. BOOTP es un protocolo de red que se utiliza para obtener información de la dirección IP durante el arranque.
  • Protocolo de oficina de correos (POP): es un protocolo que utilizan los clientes de correo electrónico para recuperar el correo electrónico de un servidor remoto.
  • Protocolo de acceso a mensajes de Internet (IMAP): este es otro protocolo que se utiliza para recuperar correo electrónico.
Los protocolos de capa de aplicación son utilizados tanto por los dispositivos de origen como de destino durante una sesión de comunicación. Para que las comunicaciones se lleven a cabo correctamente, los protocolos de capa de aplicación que se implementaron en los hosts de origen y de destino deben ser compatibles.
Resultado de imagen para protocolos de la capa de aplicacion tcp/ip

Servicio WWW y HTTP (Protocolo de transferencia de hipertexto)

La World Wide Web (WWW) o red informática mundial es un sistema de distribución de documentos de hipertexto o hipermedios interconectados y accesibles vía Internet. Con un navegador web, un usuario visualiza sitios web compuestos de páginas web que pueden contener textos, imágenes, vídeos u otros contenidos multimedia, y navega a través de esas páginas usando hiperenlaces.
La Web se desarrolló entre marzo de 1989 y diciembre de 1990. Por el inglés Tim Berners-Lee con la ayuda del belga Robert Cailliau mientras trabajaban en el CERN en Ginebra, Suiza, y publicado en 1992. Desde entonces, Berners-Lee ha jugado un papel activo guiando el desarrollo de estándares Web (como los lenguajes de marcado con los que se crean las páginas web), y en los últimos años ha abogado por su visión de una Web semántica. Utilizando los conceptos de sus anteriores sistemas de hipertexto como ENQUIRE, el físico británico Tim Berners-Lee, un científico de la computación y en ese tiempo de los empleados del CERN, ahora director del World Wid Web Consortium (W3C), escribió una propuesta en marzo de 1989 con lo que se convertiría en la World Wide Web. La propuesta de 1989 fue destinada a un sistema de comunicación CERN pero Berners-Lee finalmente se dio cuenta que el concepto podría aplicarse en todo el mundo.


El Protocolo de Transferencia de HiperTexto (Hypertext Transfer Protocol) es un sencillo protocolo cliente-servidor que articula los intercambios de información entre los clientes Web y los servidores HTTP. La especificación completa del protocolo HTTP 1/0 está recogida en el RFC 1945. Fue propuesto por Tim Berners-Lee, atendiendo a las necesidades de un sistema global de distribución de información como el World Wide Web.

Desde el punto de vista de las comunicaciones, está soportado sobre los servicios de conexión TCP/IP, y funciona de la misma forma que el resto de los servicios comunes de los entornos UNIX: un proceso servidor escucha en un puerto de comunicaciones TCP (por defecto, el 80), y espera las solicitudes de conexión de los clientes Web. Una vez que se establece la conexión, el protocolo TCP se encarga de mantener la comunicación y garantizar un intercambio de datos libre de errores.

HTTP se basa en sencillas operaciones de solicitud/respuesta. Un cliente establece una conexión con un servidor y envía un mensaje con los datos de la solicitud. El servidor responde con un mensaje similar, que contiene el estado de la operación y su posible resultado. Todas las operaciones pueden adjuntar un objeto o recurso sobre el que actúan; cada objeto Web (documento HTML, fichero multimedia o aplicación CGI) es conocido por su URL.

Protocolos de correo electrónico


Uno de los principales servicios que un ISP ofrece es hosting de correo electrónico. Para ejecutar el correo electrónico en una PC o en otro terminal, se requieren varios servicios y aplicaciones, como se muestra en la figura. El correo electrónico es un método para almacenar y enviar que se utiliza para enviar, almacenar y recuperar mensajes electrónicos a través de una red. Los mensajes de correo electrónico se guardan en bases de datos en servidores de correo.

Los clientes de correo electrónico se comunican con servidores de correo para enviar y recibir mensajes de correo electrónico. Los servidores de correo se comunican con otros servidores de correo para transportar mensajes desde un dominio a otro. Un cliente de correo electrónico no se comunica directamente con otro cliente de correo electrónico cuando envía un mensaje. Más bien, ambos clientes dependen del servidor de correo para el transporte de los mensajes.


El correo electrónico admite tres protocolos diferentes para su funcionamiento: el protocolo simple de transferencia de correo (SMTP), el protocolo de oficina de correos (POP) e IMAP. El proceso de capa de aplicación que envía correo utiliza SMTP. Sin embargo, un cliente recupera el correo electrónico mediante uno de dos protocolos de capa de aplicación: POP o IMAP.

Funcionamiento de SMTP


Los formatos de mensajes SMTP necesitan un encabezado y un cuerpo de mensaje. Mientras que el cuerpo del mensaje puede contener la cantidad de texto que se desee, el encabezado debe contar con una dirección de correo electrónico de destinatario correctamente formateada y una dirección de emisor.

Cuando un cliente envía correo electrónico, el proceso SMTP del cliente se conecta a un proceso SMTP del servidor en el puerto bien conocido 25. Después de que se establece la conexión, el cliente intenta enviar el correo electrónico al servidor a través de esta. Una vez que el servidor recibe el mensaje, lo ubica en una cuenta local (si el destinatario es local) o lo reenvía a otro servidor de correo para su entrega, como se muestra en la figura.


El servidor de correo electrónico de destino puede no estar en línea, o estar muy ocupado, cuando se envían los mensajes. Por lo tanto, el SMTP pone los mensajes en cola para enviarlos posteriormente. El servidor verifica periódicamente la cola en busca de mensajes e intenta enviarlos nuevamente. Si el mensaje aún no se ha entregado después de un tiempo predeterminado de expiración, se devolverá al emisor como imposible de entregar.

Funcionamiento de POP


POP es utilizado por una aplicación para recuperar correo electrónico de un servidor de correo. Con POP, el correo se descarga desde el servidor al cliente y después se elimina en el servidor. POP funciona de esta forma, de manera predeterminada.

El servidor comienza el servicio POP escuchando de manera pasiva en el puerto TCP 110 las solicitudes de conexión del cliente. Cuando un cliente desea utilizar el servicio, envía una solicitud para establecer una conexión TCP con el servidor. Una vez establecida la conexión, el servidor POP envía un saludo. A continuación, el cliente y el servidor POP intercambian comandos y respuestas hasta que la conexión se cierra o cancela.


Con POP, los mensajes de correo electrónico se descargan en el cliente y se eliminan del servidor, esto significa que no existe una ubicación centralizada donde se conserven los mensajes de correo electrónico. Como POP no almacena mensajes, no es una opción adecuada para una pequeña empresa que necesita una solución de respaldo centralizada.


Funcionamiento de IMAP


IMAP es otro protocolo que describe un método para recuperar mensajes de correo electrónico. A diferencia de POP, cuando el usuario se conecta a un servidor con capacidad IMAP, se descargan copias de los mensajes a la aplicación cliente. Los mensajes originales se mantienen en el servidor hasta que se eliminen manualmente. Los usuarios ven copias de los mensajes en su software de cliente de correo electrónico.


Los usuarios pueden crear una jerarquía de archivos en el servidor para organizar y guardar el correo. Dicha estructura de archivos se duplica también en el cliente de correo electrónico. Cuando un usuario decide eliminar un mensaje, el servidor sincroniza esa acción y elimina el mensaje del servidor.


¿Cómo proteger nuestros datos en la red?


Los mayores niveles se concentran en cinco países: Brasil, donde 41% de las personas ha sufrido alguna vez algún delito virtual; Perú con 31% de incidencia; México registra 30%; Chile alcanza 29% y Colombia con 24%.

El phishing

El término phishing, según los expertos, proveniente del inglés “fishing” (pescando) y se utiliza para identificar la acción fraudulenta de conseguir información confidencial vía correo electrónico, con el propósito de que los receptores lo reenvíen con información real.

Este mail falso en general no es dirigido a individuos particulares, sino a grandes grupos de consumidores. La idea es hacerle creer al público que se está comunicando con su institución financiera y que conteste lo que se le pide.

Para protegerse del phishing, Altonivel realizó un compilado de precauciones que debes conocer para evitar ser parte de la larga lista de víctimas de este delito. Éstas son:

· Crea contraseñas seguras

Una de las estrategias más utilizadas por los ciberdelincuentes está relacionada con el uso de contraseñas. Para ingresar a las cuentas bancarias, prueban con diferentes combinaciones de contraseñas hasta dar con ella. Respecto de este punto, se recomiendan algunos consejos:

Por lo general, los clientes caen en el error de generar contraseñas obvias como sus nombres, apellidos, fecha de nacimiento y números correlativos. Evita este tipo de passwords.

Además utiliza contraseñas con un mínimo de siete caracteres, incluye palabras como: $, %, & y /, cambia con cierta frecuencia la contraseña, no la anotes en ningún medio escrito y, por último, nunca la envíes a través de Messenger, Facebook o Twitter.

· No brindes datos personales por e-mail

Es la forma más frecuente de protección y consiste en el envío de emails que nos “solicitan” enviar alguna información “confidencial” como contraseñas, número de cuentas bancarias, tarjetas de crédito, entre otros datos importantes.

· Ojo al realizar transacciones online

Cuando realices transacciones electrónicas, asegúrate de que la web utiliza un protocolo seguro. Esto puede comprobarse observando si la URL comienza por https://, donde la “s” indica que se trata de un sitio seguro. También debe aparecer un candado en la parte inferior derecha de la pantalla.

Dado que algunos delincuentes falsifican este símbolo, es conveniente comprobar su autenticidad haciendo doble clic sobre él: de esta forma, aparecerá la autoridad certificadora de la seguridad del sitio.

· Fíjate en los títulos de los mensajes


Según los expertos, las frases más utilizadas en los correos electrónicos destinados para cometer este tipo de delitos son:

– “Seguridad y mantenimiento”
– “Investigación de irregularidades”
– “Personalización de cuentas”
– “Su cuenta ha sido congelada”
– “Tenemos que reconfirmar sus datos”
– “Su tarjeta de crédito ha sido cancelada”
– “Usted tiene una suma grande de dinero en su cuenta, por favor verifique sus movimientos”
– “Actualice sus datos”

lunes, 12 de junio de 2017

2.3

PROPOSITO DE LA CAPA DE TRANSPORTE

Seguimiento de Conversaciones individuales

Cualquier host puede tener múltiples aplicaciones que se están comunicando a través de la red. Cada una de estas aplicaciones se comunicará con una o más aplicaciones en hosts remotos. Es responsabilidad de la capa de Transporte mantener los diversos streams de comunicación entre estas aplicaciones.

Segmentación de datos

Debido a que cada aplicación genera un stream de datos para enviar a una aplicación remota, estos datos deben prepararse para ser enviados por los medios en partes manejables. Los protocolos de la capa de Transporte describen los servicios que segmentan estos datos de la capa de Aplicación. Esto incluye la encapsulación necesaria en cada sección de datos. Cada sección de datos de aplicación requiere que se agreguen encabezados en la capa de Transporte para indicar la comunicación a la cual está asociada.

Reensamble de segmentos

En el host de recepción, cada sección de datos puede ser direccionada a la aplicación adecuada. Además, estas secciones de datos individuales también deben reconstruirse para generar un stream completo de datos que sea útil para la capa de Aplicación. Los protocolos de la capa de Transporte describen cómo se utiliza la información de encabezado de dicha capa para reensamblar las secciones de datos en streams y enviarlas a la capa de Aplicación.

Identificación de las aplicaciones

Para poder transferir los streams de datos a las aplicaciones adecuadas, la capa de Transporte debe identificar la aplicación de destino. Para lograr esto, la capa de Transporte asigna un identificador a la aplicación. Los protocolos TCP/IP denominan a este identificador número de puerto. A todos los procesos de software

separación de comunicaciones múltiples

Considere una computadora conectada a una red que recibe y envía e-mails y mensajes instantáneos, explora sitios Web y realiza una llamada telefónica de VoIP de manera simultánea. Cada una de estas aplicaciones envía y recibe datos en la red al mismo tiempo. Sin embargo, los datos de la llamada telefónica no se direccionan al explorador Web y el texto de un mensaje instantáneo no aparece en el e-mail.

4.1.1_Proposito_de_la_capa_de_transporte.jpg


Administración de datos 
Cuando los datos llegan a la capa de transporte, los protocolos de la capa inician el proceso de encapsulado de datos. La capa de transporte encapsula los datos de aplicación en unidades de datos de protocolo de transporte.

El protocolo de capa de transporte crea un flujo virtual de datos entre la aplicación de envío y la de recepción, que se identifica con un número de puerto de transporte. El número de puerto identifica un puerto, una ubicación dedicada de la memoria par recibir o enviar datos. Además, la capa de protocolo de transporte puede proporcionar otros servicios, como la entrega de datos ordenada y fiable. El resultado final depende de si la información se maneja con los protocolos TCP, SCTP o UDP.
Segmentación TCP

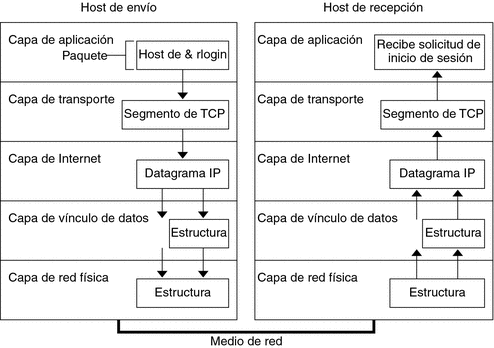
TCP se denomina a menudo protocolo "orientado a la conexión" porque TCP garantiza la entrega correcta de los datos al host de recepción. La Figura 1–1 muestra cómo el protocolo TCP recibe el flujo del comando rlogin. A continuación, TCP divide los datos que se reciben de la capa de aplicación en segmentos y adjunta un encabezado a cada segmento.
Figura 1–1 Transferencia de un paquete a través de la pila TCP/IP

El diagrama muestra cómo se transfiere un paquete a través de la pila TCP/IP desde el host de envío hasta el de recepción.

Los encabezados de segmento contienen puertos de envío y recepción, información de orden de los segmentos y un campo de datos conocido como suma de comprobación. Los protocolos TCP de ambos hosts utilizan los datos de suma de comprobación para determinar si los datos se transfieren sin errores.
Establecimiento de una conexión TCP

TCP utiliza segmentos para determinar si el sistema de recepción está listo para recibir los datos. Cuando el protocolo TCP de envío desea establecer conexiones, envía un segmento denominado SYN al protocolo TCP del host de recepción. El protocolo TCP de recepción devuelve un segmento denominado ACK para confirmar que el segmento se ha recibido correctamente. El protocolo TCP de envío emite otro segmento ACK y luego procede al envío de los datos. Este intercambio de información de control se denomina protocolo de tres vías.
Paquetes UDP

UDP es un protocolo "sin conexiones". A diferencia de TCP, UDP no comprueba los datos que llegan al host de recepción. En lugar de ello, UDP da formato al mensaje que se recibe desde la capa de la aplicación en los paquetes UDP. UDP adjunta un encabezado a cada paquete. El encabezado contiene los puertos de envío y recepción, un campo con la longitud del paquete y una suma de comprobación.

El proceso UDP de envío intenta enviar el paquete a su proceso UDP equivalente en el host de recepción. La capa de aplicación determina si el proceso UDP de recepción confirma la recepción del paquete. UDP no requiere ninguna notificación de la recepción. UDP no utiliza el protocolo de tres vías.


Establecimiento de una conexión

El establecimiento de una conexión parece fácil, pero en realidad es sorprendentemente difícil. A primera vista, parecería que es suficiente con mandar una TPDU (Unidad de Datos del Protocolo de Transporte) con la petición de conexión y esperar a que el otro acepte la conexión. El problema viene cuando la red puede perder, almacenar, o duplicar paquetes. El principal problema es la existencia de duplicados retrasados. Esto puede solucionarse de varias maneras (ninguna es muy satisfactoria). Una es utilizar direcciones de transporte desechables. En este enfoque cada vez que necesitemos una dirección la creamos. Al liberarse la conexión descartamos la dirección y no se vuelve a utilizar. O también asignar una secuencia dentro de los datos transmitidos, pero estos plantean el problema de que si se pierde la conexión perdemos el orden del identificador y ya no funciona. La solución seria más fácil si los paquetes viejos se eliminaran de la subred cada cierto tiempo de vida. Para ello podemos utilizar las siguientes técnicas: Un diseño de subred Restringido. Colocar un contador de saltos en cada paquete. Marcar el tiempo de cada paquete. Pero en la práctica no vale solo con hacer esto sino que tenemos que garantizar que todas las confirmaciones de los paquetes también se eliminan.


Liberación de una conexión

La liberación de una conexión es más fácil que su establecimiento. No obstante, hay más escollos de los que uno podría imaginar. Hay dos estilos de terminación de una conexión: liberación asimétrica y liberación simétrica. La liberación asimétrica es la manera en que funciona el mecanismo telefónico: cuando una parte cuelga, se interrumpe la conexión. La liberación simétrica trata la conexión como dos conexiones unidireccionales distintas, y requiere que cada una se libere por separado. La liberación asimétrica es abrupta y puede resultar en la pérdida de datos. Por lo que es obvio que se requiere un protocolo de liberación más refinado para evitar la pérdida de datos. Una posibilidad es usar la liberación simétrica, en la que cada dirección se libera independientemente de la otra. Aquí, un hoste puede continuar recibiendo datos aun tras haber enviado una TPDU de desconexión.

La liberación simétrica es ideal cuando un proceso tiene una cantidad fija de datos por enviar y sabe con certidumbre cuándo los ha enviado. En otras situaciones, la determinación de si se ha efectuado o no todo el trabajo y se debe terminarse o no la conexión no es tan obvia. Podríamos pensar en un protocolo en el que el host 1 diga:”Ya termine, ¿Terminaste también?”. Si el host 2 responde “Ya termine también. Adiós”, la conexión puede liberarse con seguridad.

Pero no es tan fiable por el problema de que siempre tendremos que esperar la confirmación de los mensajes recibidos y si esta confirmación no llega no libera la conexión y después puede que necesite la confirmación de que llegó la confirmación y entraríamos en un bucle del que no podemos salir.

Podemos hacer que al host 1 si no le llega la confirmación después de N intentos (es que quiere la desconexión), se libere. Esto produce una conexión semiabierta en la que el host 1 está desconectado pero el host 2 no como no le llega la confirmación no se desconecta nunca. Para solucionar esto creamos una regla por la cual si al host 2 no le llega ninguna TPDU durante cierta cantidad de segundos, se libera automáticamente.


Reconocimiento y transmisión de datos

Los servicios basados en TCP y UDP mantienen un seguimiento de las diversas aplicaciones que se comunican. Para diferenciar los segmentos y datagramas para cada aplicación, tanto TCP como UDP cuentan con campos de encabezado que pueden identificar de manera exclusiva estas aplicaciones. Estos identificadores únicos son números de puertos.
Los números de puerto se asignan de distintas maneras, en virtud de si el mensaje es una solicitud o una respuesta. Mientras que los procesos del servidor tienen números de puerto estáticos asignados, los clientes eligen de forma dinámica un número de puerto para cada conversación.
La combinación del número de puerto de la capa de transporte y de la dirección IP de la capa de red asignada al host identifica de manera exclusiva un proceso en particular que se ejecuta en un dispositivo host específico. Esta combinación se denomina socket. Eventualmente, los términos número de puerto y socket se utilizan en forma indistinta.
Hay diversos tipos de números de puerto:
Puertos bien conocidos (números del 0 al 1023): estos números se reservan para servicios y aplicaciones.
Puertos registrados (números del 1024 al 49151): estos números de puerto se asignan a procesos o aplicaciones del usuario. Estos procesos son principalmente aplicaciones individuales que el usuario elige instalar en lugar de aplicaciones comunes que recibiría un puerto bien conocido.
Puertos dinámicos o privados (números 49152 a 65535): también conocidos como puertos efímeros, están usualmente asignados de forma dinámica a las aplicaciones cliente cuando se inicia una conexión. 


Multiplexión

La multiplexión de varias conversaciones en conexiones, circuitos virtuales o enlaces físicos desempeña un papel importante en diferentes capas de la arquitectura de red. En la capa de transporte puede surgir la necesidad de multiplexión por varias razones. Por ejemplo, si en un host sólo se dispone de una dirección de red, todas las conexiones de transporte de esa máquina tendrán que utilizarla. Cuando llega una TPDU, se necesita algún mecanismo para saber a cuál proceso asignarla. Esta situación se conoce como multiplexión hacia arriba.

La multiplexión también puede ser útil en la capa transporte para la utilización de circuitos virtuales, que dan más ancho de banda cuando se reasigna a cada circuito una tasa máxima de datos. La solución es abrir múltiples conexiones de red y distribuir el tráfico entre ellas. Esto se denomina multiplexión hacia abajo..

2.2

Capa de Red

La Capa de Red provee principalmente los servicios de envío, enrutamiento(routing) y control de congestionamiento de los datos (paquetes de datos) de un nodo a otro en la red, esta es la capa más inferior en cuanto a manejo de transmisiones punto a punto.
El propósito de esta capa es el de formar una interfase entre los usuarios de una máquina y la red, esto es, la red es controlada por esta capa y las 2 primeras.
Los servicios que se proveen deberán ser independientes de la tecnologia de soporte.
El diseño de la capa no debe evitar el conectar dos redes con diferentes tecnologias.
La capa de Transporte debe de estar protegida del número, tipo y las diferentes topologias que se utilizen en la subred.
Todo lo que a esta capa le interesa es un camino de comunicación y no la forma en que este se construye.
Se necesita presentar un esquema de direccionamiento para direcciones de la red.


IPv4

El Protocolo de Internet versión 4, en inglés: Internet Protocol version 4 (IPv4), es la cuarta versión del Internet Protocol (IP). Es uno de los protocolos centrales de los métodos estándares de interconexión de redes basados en Internet, y fue la primera versión implementada para la producción de ARPANET, en 1983. IPv4 usa direcciones de 32 bits, limitándola a  = 4 294 967 296 direcciones únicas, muchas de las cuales están dedicadas a redes locales (LAN).Por el crecimiento enorme que ha tenido Internet (mucho más de lo que esperaba, cuando se diseñó IPv4), combinado con el hecho de que hay desperdicio de direcciones en muchos casos (ver abajo), ya hace varios años se vio que escaseaban las direcciones IPv4
Esta limitación ayudó a estimular el impulso hacia IPv6, que a 2016 está en las primeras fases de implantación, y se espera que termine reemplazando a IPv4.
Las direcciones disponibles en la reserva global de IANA pertenecientes al protocolo IPv4 se agotaron oficialmente el lunes 31 de enero de 2011.2 Los Registros Regionales de Internet deben, desde ahora, manejarse con sus propias reservas, que se estima, alcanzaran hasta el 2020.

Función de los campos de encabezado 
Los encabezados de paquetes IPV4 constan de campos que contienen información importante sobre el paquete. Estos campos contienen números binarios que se examinan en el proceso de capa 3. Los valores binarios de cada campo identifican las distintas configuraciones del paquete IP.
Los campos importantes del encabezado de IPv4 incluyen los siguientes:
  • Versión: contiene un valor binario de 4 bits que identifica la versión del paquete IP. Para los paquetes IPv4, este campo siempre se establece en 0100.
  • Servicios diferenciados (DS): anteriormente denominado “Tipo de servicio” (ToS), se trata de un campo de 8 bits que se utiliza para determinar la prioridad de cada paquete. Los primeros 6 bits identifican el valor del Punto de código de servicios diferenciados (DSCP), utilizado por un mecanismo de calidad de servicio (QoS). Los últimos 2 bits identifican el valor de Notificación explícita de congestión (ECN), que se puede utilizar para evitar que los paquetes se descarten durante momentos de congestión de la red.
  • Tiempo de vida (TTL): contiene un valor binario de 8 bits que se utiliza para limitar la vida útil de un paquete. Se especifica en segundos, pero comúnmente se denomina “conteo de saltos”. El emisor del paquete establece el valor inicial de tiempo de vida (TTL), el que disminuye un punto por cada salto, es decir, cada vez que el paquete es procesado por un router. Si el campo TTL disminuye a cero, el router descarta el paquete y envía un mensaje del protocolo de mensajes de control de Internet (ICMP) de Tiempo superado a la dirección IP de origen. El comando traceroute utiliza este campo para identificar los routers utilizados entre el origen y el destino.
  • Protocolo: este valor binario de 8 bits indica el tipo de contenido de datos que transporta el paquete, lo que permite que la capa de red pase los datos al protocolo de capa superior correspondiente. Los valores comunes incluyen ICMP (1), TCP (6) y UDP (17).
  • Dirección IP de origen: contiene un valor binario de 32 bits que representa la dirección IP de origen del paquete.
  • Dirección IP de destino: contiene un valor binario de 32 bits que representa la dirección IP de destino del paquete.
Los dos campos que más comúnmente se toman como referencia son las direcciones IP de origen y de destino. Estos campos identifican de dónde proviene el paquete y adónde va. Por lo general, estas direcciones no se modifican durante la transferencia desde el origen hasta el destino.
Resultado de imagen para funcion en los campos de encabezados

Tabla de Enrutamiento
En este capítulo conoceremos a fondo la tabla de enrutamiento , comprenderemos como es su estructura y formato además el proceso de búsqueda que realiza el router sobre la tabla de enrutamiento.

La tabla de enrutamiento consta consta de entradas de ruta de los siguientes origenes:
  • Redes conectadas directamente.
  • Rutas estáticas.
  • Protocolos de enrutamiento dinámico.

Podemos visualizar el contenido de la tabla mediante el comando show ip route.

La tabla de enrutamiento, en realidad, es una estructura jerárquica que se usa para acelerar el proceso de búsqueda cuando se ubican rutas y se reenvían paquetes. Dentro de esta estructura, la jerarquía incluye varios niveles (nivel 1 y nivel 2).

Ruta de nivel 1
Una ruta de nivel 1 es aquella ruta con una máscara de subred igual o inferior a la máscara con clase de la dirección de red.
EJ 192.168.1.0 /24 es una ruta de red de nivel 1 por que la máscara de subred es igual a la máscara con clase de la red.
También la ruta 192.168.1.0 /24 es una ruta final ya que incluye una dirección IP del siguiente salto y/o una interfaz de salida Serial0/0/1.

Ruta Principal de nivel 1

Es una ruta de red que no contiene ninguna direccion IP del siguiente salto ni ninguna interfaz de salida para ninguna red. Una ruta principal es, en realidad, un encabezado que indica la presencia de rutas de nivel 2, también conocidas como rutas secundarias.
EJ: 172.16.0.0/24 is subnetted, 1 subnets.

Ruta de nivel 2

Es una ruta que es una subred de una dirección con clase. El origen de una ruta nivel 2 puede ser una red conectada directamente, una ruta estática o un protocolo de enrutamiento dinámico. En este caso, la ruta de nivel 2 es la ruta de subred real que se agregó a la red cuando se configuro la interfaz.
EJ C 172.16.3.0 is directuly connected, FastEthernet0/0

Componentes de un router


Los componentes básicos de la arquitectura interna de un router comprenden: CPU: La unidad central de procesamiento. (CPU) ejecuta las instrucciones del sistema operativo. Estas funciones incluyen la inicialización del sistema, las funciones de enrutamiento y el control de la interfaz de red. La CPU es un microprocesador. Los grandes routers pueden tener varias CPU.
RAM: La memoria de acceso aleatorio (RAM) se usa para la información de las tablas de enrutamiento, el caché de conmutación rápida, la configuración actual y las colas de paquetes. En la mayoría de los routers, la RAM proporciona espacio de tiempo de ejecución para el software IOS de Cisco y sus subsistemas. El contenido de la RAM se pierde cuando se apaga la unidad. En general, la RAM es una memoria de acceso aleatorio dinámica (DRAM) y puede actualizarse agregando más Módulos de memoria en línea doble (DIMM).
Memoria flash: La memoria flash se utiliza para almacenar una imagen completa del software IOS de Cisco. Normalmente el router adquiere el IOS por defecto de la memoria flash. Estas imágenes pueden actualizarse cargando una nueva imagen en la memoria flash. El IOS puede estar comprimido o no. En la mayoría de los routers, una copia ejecutable del IOS se transfiere a la RAM durante el proceso de arranque. En otros routers, el IOS puede ejecutarse directamente desde la memoria flash. Agregando o reemplazando los Módulos de memoria en línea simples flash (SIMMs) o las tarjetas PCMCIA se puede actualizar la cantidad de memoria flash.
NVRAM: La memoria de acceso aleatorio no volátil (NVRAM) se utiliza para guardar la configuración de inicio. En algunos dispositivos, la NVRAM se implementa utilizando distintas memorias de solo lectura programables, que se pueden borrar electrónicamente (EEPROM). En otros dispositivos, se implementa en el mismo dispositivo de memoria flash desde donde se cargó el código de arranque. En cualquiera de los casos, estos dispositivos retienen sus contenidos cuando se apaga la unidad.
Buses: La mayoría de los routers contienen un bus de sistema y un bus de CPU. El bus de sistema se usa para la comunicación entre la CPU y las interfaces y/o ranuras de expansión. Este bus transfiere los paquetes hacia y desde las interfaces.
La CPU usa el bus para tener acceso a los componentes desde el almacenamiento del router. Este bus transfiere las instrucciones y los datos hacia o desde las direcciones de memoria especificadas.
ROM: La memoria de solo lectura (ROM) se utiliza para almacenar de forma permanente el código de diagnóstico de inicio (Monitor de ROM). Las tareas principales de la ROM son el diagnóstico del hardware durante el arranque del router y la carga del software IOS de Cisco desde la memoria flash a la RAM. Algunos routers también tienen una versión más básica del IOS que puede usarse como fuente alternativa de arranque. Las memorias ROM no se pueden borrar. Sólo pueden actualizarse reemplazando los chips de ROM en los tomas.
Interfaces: Las interfaces son las conexiones de los routers con el exterior. Los tres tipos de interfaces son la red de área local (LAN), la red de área amplia (WAN) y la Consola/AUX. Las interfaces LAN generalmente constan de uno de los distintos tipos de Ethernet o Token Ring. Estas interfaces tienen chips controladores que proporcionan la lógica necesaria para conectar el sistema a los medios. Las interfaces LAN pueden ser configuraciones fijas o modulares.
Las interfaces WAN incluyen la Unidad de servicio de canal (CSU) integrada, la RDSI y la serial. Al igual que las interfaces LAN, las interfaces WAN también cuentan con chips controladores para las interfaces. Las interfaces WAN pueden ser de configuraciones fijas o modulares.
Los puertos de Consola/AUX son puertos seriales que se utilizan principalmente para la configuración inicial del router. Estos puertos no son puertos de networking. Se usan para realizar sesiones terminales desde los puertos de comunicación del computador o a través de un módem.
Fuente de alimentación: La fuente de alimentación brinda la energía necesaria para operar los componentes internos. Los routers de mayor tamaño pueden contar con varias fuentes de alimentación o fuentes modulares. En algunos de los routers de menor tamaño, la fuente de alimentación puede ser externa al router.


Las interfaces del router se pueden agrupar en dos categorías:
  • Interfaces LAN Ethernet: se utilizan para conectar cables que terminan en dispositivos LAN, como PC y switches. La interfaz también puede utilizarse para conectar routers entre sí. Existen varias convenciones de nomenclatura de uso frecuente para las interfaces Ethernet: Ethernet antigua, FastEthernet y Gigabit Ethernet. El nombre utilizado depende del tipo y el modelo de dispositivo.
  • Interfaces WAN seriales: se utilizan para conectar routers a redes externas, generalmente a una distancia geográfica más extensa. Al igual que las interfaces LAN, cada interfaz WAN serial tiene su propia dirección IP y su máscara de subred, que la identifican como miembro de una red específica.
En la ilustración, se muestran las interfaces LAN y seriales del router.

Resultado de imagen para interfaces de un router


El proceso de arranque consta de tres fases principales:
1. Llevar a cabo el POST y cargar el programa bootstrap.
2. Localizar y cargar el software Cisco IOS.
3. Localizar y cargar el archivo de configuración de inicio o ingresar al modo Setup.

1. Llevar a cabo el POST y cargar el programa bootstrap

La prueba de Autodiagnóstico al encender (POST, Power-On Self Test) es un proceso común que ocurre en casi todas las computadoras durante el arranque. El proceso de POST se utiliza para probar el hardware del router. Cuando se enciende el router, el software en el chip de la ROM ejecuta el POST. Durante este autodiagnóstico, el router ejecuta desde la ROM diagnósticos de varios componentes de hardware, incluidos la CPU, la RAM y la NVRAM. Una vez finalizado el POST, el router ejecuta el programa bootstrap.

Después del POST, el programa bootstrap se copia de la ROM a la RAM. Una vez en la RAM, la CPU ejecuta las instrucciones del programa bootstrap. La tarea principal del programa bootstrap es ubicar al Cisco IOS y cargarlo en la RAM.

Nota: en este momento, si existe una conexión de consola al router, comienzan a aparecer resultados en pantalla.

2. Localizar y cargar Cisco IOS

Por lo general, el IOS se almacena en la memoria flash y se copia en la RAM para que lo ejecute la CPU. Durante la autodescompresión del archivo de imagen de IOS, se muestra una cadena de símbolos de almohadilla (#).

Si la imagen de IOS no se encuentra en la memoria flash, el router puede buscarla con un servidor TFTP. Si no se puede localizar una imagen de IOS completa, se copia una versión reducida del IOS de la ROM a la RAM. Esta versión del IOS se usa para ayudar a diagnosticar cualquier problema y puede usarse para cargar una versión completa del IOS en la RAM.

3. Localizar y cargar el archivo de configuración

A continuación, el programa bootstrap busca el archivo de configuración de inicio (también conocido como “startup-config”) en la NVRAM. El archivo contiene los parámetros y comandos de configuración guardados anteriormente. Si existe, se copia en la RAM como archivo de configuración en ejecución o “running-config”. El archivo running-config contiene direcciones de interfaz, inicia los procesos de enrutamiento, configura las contraseñas del router y define otras características del dispositivo.

Si el archivo startup-config no existe en la NVRAM, el router puede buscar un servidor de protocolo trivial de transferencia de archivos (TFTP). Si el router detecta que tiene un enlace activo a otro router configurado, envía un broadcast en busca de un archivo de configuración a través del enlace activo.

Si no se encuentra un servidor TFTP, el router muestra la petición de entrada del modo Setup. El modo Setup consiste en una serie de preguntas que solicitan al usuario información de configuración básica. El modo Setup no tiene como fin utilizarse para ingresar a configuraciones complejas del router y los administradores de red normalmente no lo usan.